TL;DR: Empezaba un semestre con 516 clases sin profesor asignado y 706 candidatos posibles. Escribí un programa que propone quién puede dictar cada una sin romper los topes de horas que fija el reglamento. Mi primera versión, un algoritmo simple, le dio 26 clases a una sola persona. La reemplacé por un modelo CP-SAT de OR-Tools: la cobertura subió a 94 %, el máximo por profesor bajó a 18 y la coincidencia con lo que decidieron los humanos pasó de 8 % a 20 %. Pero lo que más mejoró el resultado no fue el solver, sino seis reglas del mundo real que solo aparecieron revisando casos uno por uno.
¿Por qué repartir clases entre profesores es un problema difícil?
Porque no basta con que la persona sepa del tema: tiene que tener el título que esa materia exige, horas libres dentro de su tope legal, y estar en la ciudad correcta. Cada clase que asignas cambia lo que queda disponible para todas las demás. Es el mismo tipo de problema que armar los turnos de un hospital o las rutas de una flota de camiones.
Los números del caso que trabajé: 2.694 clases creadas para el semestre, 2.179 ya con profesor y 516 sin nadie asignado. El grupo de candidatos era de 706 profesores. A ojo, son más de 360.000 combinaciones posibles, y casi todas ilegales por algún motivo.
Y había un obstáculo previo, que es el que hace interesante el caso: el requisito de cada materia no existía en ningún sistema. Solo estaba escrito en documentos PDF que cada carrera arma para los trámites de acreditación. Extraje 1.438 requisitos de asignatura de 47 documentos con PyMuPDF y los crucé contra la lista real de profesores leída desde una base PostgreSQL. Sin ese paso, no hay algoritmo que valga: no tendría contra qué comparar.
Para puntuar cada par clase-profesor uso comparación difusa de títulos con rapidfuzz, con 40 puntos al título de grado, 40 al de posgrado y 10 a cada tipo de experiencia. Un par entra al modelo solo si supera 75 sobre 100.
¿Qué es un algoritmo goloso y por qué falló?
Un algoritmo goloso resuelve una decisión a la vez, siempre eligiendo lo mejor del momento, y nunca vuelve atrás. El mío ordenaba las clases por escasez —primero las que tienen menos candidatos— y a cada una le daba el mejor profesor disponible con horas libres. Son cinco líneas de código y corre en menos de un segundo.
En papel funcionaba: el puntaje medio de ajuste al perfil daba 89,4 sobre 100, altísimo. El problema aparece al mirar el conjunto en vez de cada decisión. El goloso le asignó 26 clases a una sola persona y resolvió el semestre completo con 332 profesores, donde los coordinadores reales usan 488.
Piénsalo en términos humanos: el algoritmo encontró a los diez mejores perfiles de la institución y les cargó todo encima. Cada decisión, vista sola, era la mejor posible. El resultado, visto completo, era impresentable. Ninguna coordinación firma un reparto donde alguien dicta 26 materias.
Ese fue el momento en que dejé de tratarlo como un problema de emparejamiento y lo traté como un problema de optimización con restricciones globales: alguien tiene que mirar el tablero entero.
¿Qué reglas del mundo real tuve que meter al modelo?
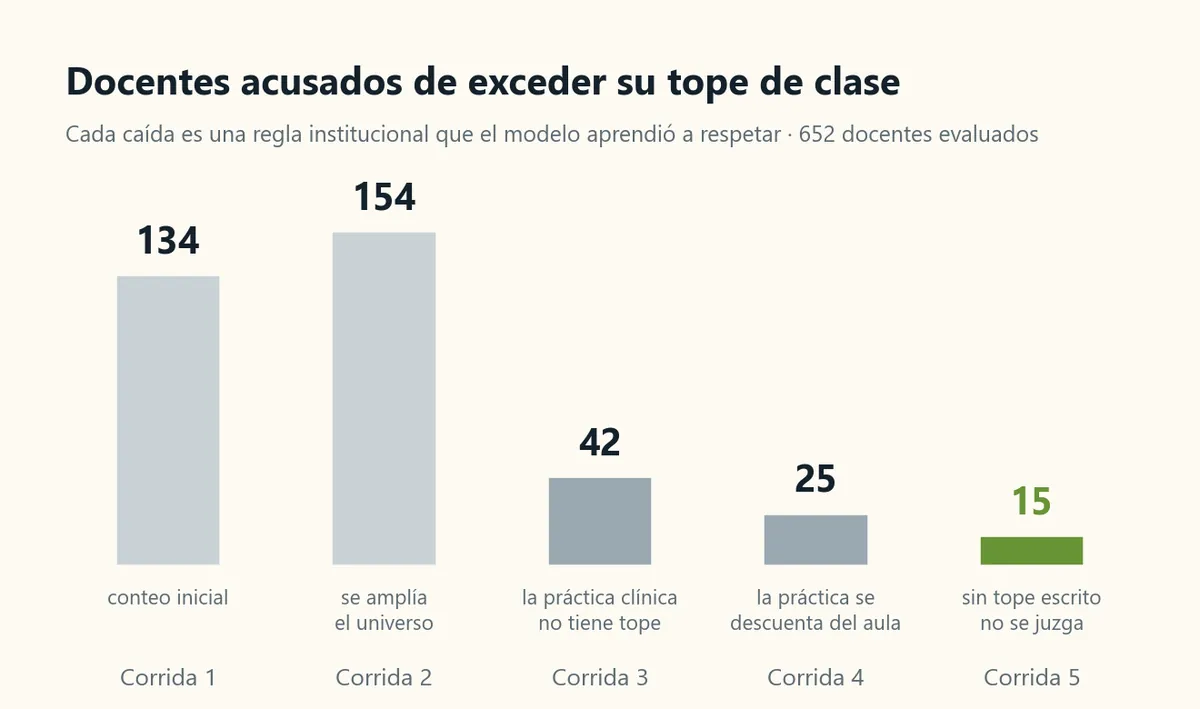
Seis, y ninguna estaba en el pedido original. Todas salieron de bajar al caso individual cada vez que el programa señalaba algo alarmante. La lista de profesores que el modelo acusaba de exceder su tope de horas resume bien ese proceso: empezó en 134 personas y terminó en 15.
Las tres correcciones que más peso tuvieron:
- Las horas son las de la persona, no las de la materia. Un profesor aparecía con 55 horas semanales, una barbaridad. Su carga real era de 14,2: en las clases en línea y en las que dictan dos o más docentes, las horas se reparten entre ellos. Yo estaba sumando la columna equivocada.
- La práctica supervisada cuenta como clase, pero no tiene tope escrito. Una profesora marcaba 36 horas. Eran rotaciones de práctica con cinco docentes por materia, una modalidad que la tabla de topes ni siquiera contempla. Y descubrí que la regla es de la hora, no del área: otro caso con 26,6 horas resultó ser 17,6 de aula más 9 de práctica, en un área que yo había asumido que no hacía prácticas.
- Sin tope escrito, no se juzga. Tres profesores de medio tiempo aparecían con 19 horas contra un tope de 12. Pero su unidad se rige por otra tabla, y para su tipo de contrato esa tabla no tiene fila. El tope que yo había inventado como respaldo servía para limitar cuánto proponerle a alguien; usarlo para acusarlo era un error de diseño.
Esa última distinción quedó escrita en el código, porque es la que más fácil se pierde en el siguiente refactor:
TOPE_CLASE_TC_SIMULACION = 20.0
TOPE_SIN_CATALOGO = 12.0        # solo capacidad al proponer; nunca juzga


def tope_clase_simulacion(dedicacion, escalafon, area="GENERAL"):
    """El tope de clase que usa la simulación. `None` = no se juzga."""
    ded = " ".join((dedicacion or "").upper().split())
    if ded == "TIEMPO COMPLETO" and area != "IDIOMAS":
        return TOPE_CLASE_TC_SIMULACION      # regla institucional, 20 h planas
    t = norma.tope_clase(dedicacion, escalafon, area)
    return t.maximo if t else None           # sin fila en el catálogo: None


def capacidad_tope(dedicacion, escalafon, area="GENERAL"):
    """Capacidad para PROPONER carga: el tope real o el respaldo conservador."""
    t = tope_clase_simulacion(dedicacion, escalafon, area)
    return t if t is not None else TOPE_SIN_CATALOGO


def aula(horas_docente, horas_practica):
    """Horas de aula juzgables: las de la PERSONA menos su práctica declarada."""
    return max(0.0, float(horas_docente or 0) - float(horas_practica or 0))
Fíjate en el None. No es un descuido: significa «no tengo norma escrita para este caso, así que no emito juicio». Devolver un número ahí —cualquier número— convierte una laguna del reglamento en una acusación contra una persona.
Las dos miradas conviven a propósito. El catálogo normativo completo (16, 18, 20 o 22 horas según categoría) sigue intacto porque alimenta el reporte que audita contra el reglamento escrito. La simulación usa 20 horas planas porque responde otra pregunta: cuánta clase puede asumir esta persona. Hay una prueba automática que vigila que nadie unifique las dos por prolijidad.
¿Cómo funciona el modelo CP-SAT?
CP-SAT es el solver de restricciones de OR-Tools, la librería de optimización de Google. En vez de decidir clase por clase, le describes todas las decisiones a la vez, todas las reglas que no puede romper y qué es lo que quieres maximizar; él busca la mejor combinación global.
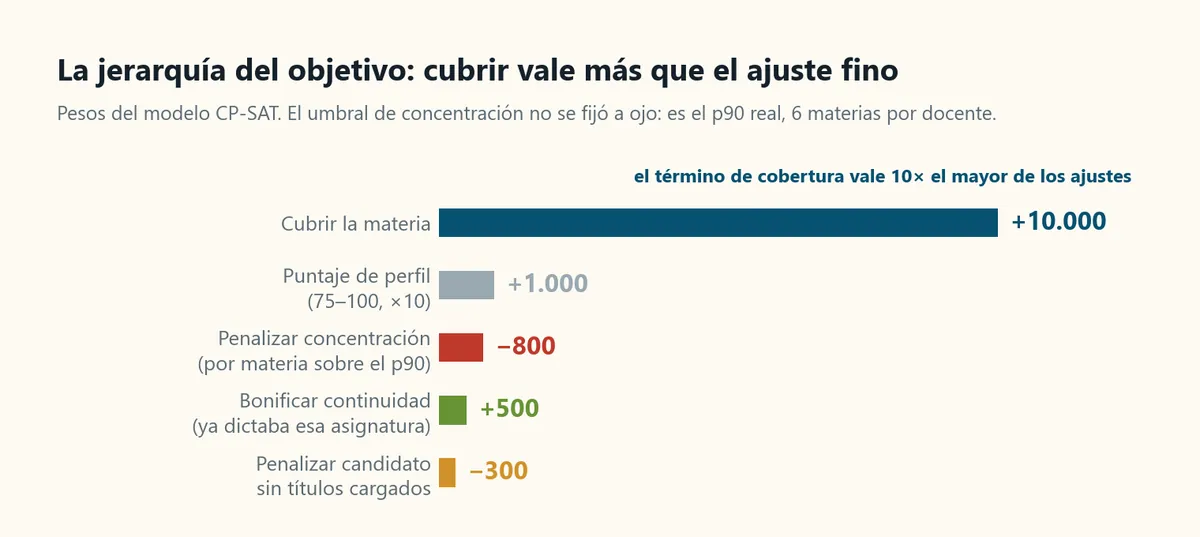
Mi modelo tiene una variable binaria x[clase, profesor] por cada par que ya pasó el filtro de perfil y de ciudad, tres restricciones y un objetivo por capas donde cubrir una clase vale más que cualquier ajuste fino.
from ortools.sat.python import cp_model

W_COBERTURA, W_CONTINUIDAD, W_EXCESO, W_SIN_VERIFICAR = 10_000, 500, 800, 300

modelo = cp_model.CpModel()
x, por_materia, por_docente = {}, defaultdict(list), defaultdict(list)

for v in materias:
    for pid, puntaje, semaforo in aptos[v["materia_id"]]:
        var = modelo.NewBoolVar(f"x_{v['materia_id']}_{pid}")
        x[(v["materia_id"], pid)] = (var, puntaje, semaforo, v)
        por_materia[v["materia_id"]].append(var)
        # las horas van x10 para trabajar con enteros
        por_docente[pid].append((var, int(round(float(v["horas"]) * 10))))

# 1. como mucho un profesor por clase
for vars_ in por_materia.values():
    modelo.AddAtMostOne(vars_)

# 2. nadie supera su tope de horas menos lo que ya tiene asignado
# 3. concentracion BLANDA: se puede pasar del umbral, pero cuesta
excesos = []
for pid, pares in por_docente.items():
    modelo.Add(sum(var * h for var, h in pares) <= int(round(capacidad[pid] * 10)))
    exceso = modelo.NewIntVar(0, len(pares), f"exc_{pid}")
    modelo.Add(exceso >= sum(var for var, _ in pares) - umbral_concentracion)
    excesos.append(exceso)

objetivo = []
for (mid, pid), (var, puntaje, semaforo, v) in x.items():
    bono = W_CONTINUIDAD if (pid, v["asignatura_id"]) in continuidad else 0
    castigo = W_SIN_VERIFICAR if semaforo == "sin_verificar" else 0
    objetivo.append(var * (W_COBERTURA + int(round(puntaje * 10)) + bono - castigo))

modelo.Maximize(sum(objetivo) - W_EXCESO * sum(excesos))

solver = cp_model.CpSolver()
solver.parameters.max_time_in_seconds = 120
solver.parameters.num_workers = 8
estado = solver.Solve(modelo)
La restricción número 3 es la que arregla el problema del goloso, y es blanda: el modelo puede darle a alguien más clases que el umbral, pero cada una extra le cuesta 800 puntos. Así, si de verdad no hay alternativa, la clase se cubre igual en lugar de quedar vacía por un exceso de rigidez.
Dos detalles que no son decorativos. El primero: el umbral de concentración no lo fijé a ojo. Lo calculo como el percentil 90 de cuántas clases dicta realmente cada profesor en el semestre anterior, que dio 6. Poner un número redondo ahí habría sido meter una opinión mía disfrazada de restricción.
El segundo: el castigo de 300 puntos a los candidatos sin verificar —los que puntúan alto pero no tienen títulos cargados en el sistema— redujo esas propuestas de 31 a 5 sin perder ni una clase de cobertura. Un candidato sin evidencia solo gana cuando de verdad no hay nadie comparable.
La restricción de ciudad no está en el modelo sino en la construcción de los pares: para clases presenciales, semipresenciales e híbridas el profesor tiene que ser de la misma sede; en línea y a distancia no hay restricción geográfica.
¿Qué pasó al comparar el algoritmo simple, el solver y las decisiones humanas?
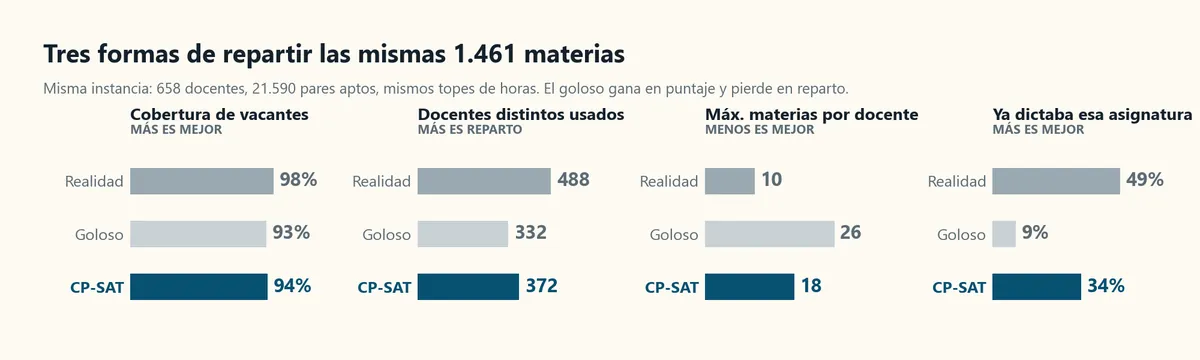
Corrí los tres sobre el mismo semestre ya cerrado —donde ya sabía qué decidieron los humanos—, con los mismos puntajes y los mismos topes, y medí siete indicadores. CP-SAT gana en todas las dimensiones de calidad, a costa de 121 segundos de cómputo contra menos de un segundo del goloso.
| Indicador | Humanos | Goloso | CP-SAT |
|---|---|---|---|
| Clases cubiertas | 98 % | 93 % | 94 % |
| Puntaje medio de perfil | 68,0 | 89,4 | 88,7 |
| Profesores distintos usados | 488 | 332 | 372 |
| Máximo de clases por profesor | 10 | 26 | 18 |
| Carga que se llevan los 10 primeros | 7 % | 10 % | 6 % |
| Coincide con la persona real | — | 8 % | 20 % |
| Ya dictaba esa materia antes | 49 % | 9 % | 34 % |
| Tiempo de cómputo | — | 0 s | 121 s |
El goloso todavía gana en puntaje medio, y eso es exactamente lo que se espera: maximiza cada decisión local. Pero 0,7 puntos más de ajuste no compensan duplicar la concentración de carga. El goloso quedó como respaldo automático, por si OR-Tools no está instalado o el solver no encuentra solución a tiempo.
El indicador que más me costó aceptar es la coincidencia persona a persona. Ni siquiera CP-SAT llega al 20 % de las decisiones reales. Esa brecha no prueba que los coordinadores se equivoquen: el modelo no conoce los horarios, ni las preferencias, ni los compromisos previos de nadie. Es un límite declarado del sistema, no un veredicto sobre las personas.
¿Por qué las horas libres que se ven no son horas que se puedan usar?
Porque una hora libre solo sirve si existe una clase concreta que esa persona pueda dictar, en su ciudad y en ese semestre. Al medir la planta encontré 5.051 horas semanales libres bajo el tope legal. Al filtrar por clase realmente compatible, la capacidad que de verdad se puede reasignar bajó a 1.811 horas.
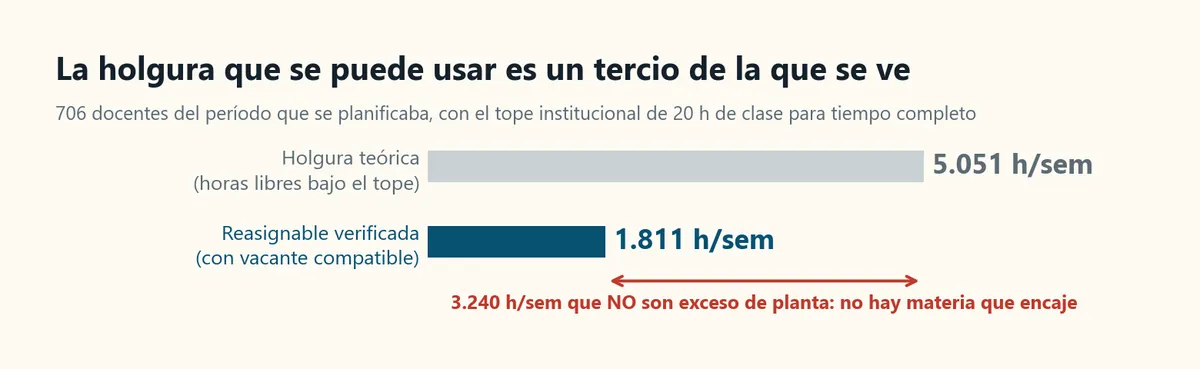
Esa diferencia de 3.240 horas es la parte del análisis con más consecuencias fuera del código, y por eso la aíslo. Presentada sin filtrar, la primera cifra se lee como «sobra gente» y se convierte en munición para una decisión de personal. Presentada con el filtro, dice otra cosa muy distinta: el recurso existe pero no hay dónde ponerlo, lo que lleva a rediseñar la oferta de clases, no a recortar plantilla.
Por eso el reporte no dice «reemplazable» en ninguna parte. Dice «carga cubierta alternativamente, a revisión», y cada fila explica qué se perdería: las horas de investigación o gestión que el reemplazo no cubre. Es el mismo criterio con el que trabajé el análisis de nuevas carreras universitarias: el dato propone, la persona decide.
Seis errores al llevar un optimizador a la vida real
| Error | Qué provoca | Cómo lo resolví |
|---|---|---|
| Sumar las horas de la clase en vez de las de la persona | Falsos excesos cuando dos docentes comparten una materia | Una sola función aula() que todos los scripts importan |
| Inventar un tope cuando el reglamento no lo tiene | Acusar a gente que cumple una norma distinta | None explícito: sin tope escrito, no se juzga |
| Fijar umbrales de equidad «a criterio» | Restricciones que son opiniones disfrazadas de matemática | El umbral sale del percentil 90 de la distribución real |
| Tratar «sin dato» como «no cumple» | Castigar a alguien por un hueco administrativo, no por su perfil | Puntaje reescalado sobre lo medible, con la falta de dato marcada aparte |
| Adoptar el algoritmo sofisticado sin comparar | No saber si mejoró ni cuánto costó | Los tres contendientes sobre el mismo caso, siete métricas |
| Copiar las mismas constantes en varios scripts | Una corrección en uno no llega a los demás | Un módulo de reglas único, con una prueba por cada lección aprendida |
La cuarta fila es la que más define el proyecto. Buena parte de la plantilla no tiene los títulos cargados en el sistema. Si eso se contara como incumplimiento, el análisis castigaría a personas por un problema de trámite. Por eso el motor devuelve tres estados —cumple, no cumple y sin dato— y el puntaje se reescala sobre los componentes que sí pudo medir.
¿Qué me llevo de este proyecto?
Que el solver fue la parte fácil. El modelo CP-SAT completo son unas sesenta líneas y la documentación de OR-Tools las explica bien. Lo que realmente hizo utilizable el resultado fue la parte lenta y poco vistosa: mirar los 134 casos señalados uno por uno, descubrir que casi todos eran reglas del negocio que yo no conocía, y escribirlas como código con su evidencia al lado.
La serie 134 → 15 no es una mejora del algoritmo. Es la distancia entre un modelo que corre y un modelo con el que alguien se anima a firmar una decisión que afecta a personas reales. Y el orden importa: primero comparar, después adoptar. Si CP-SAT hubiera perdido contra el goloso, hoy el proyecto usaría el goloso.
El sistema terminó con una suite de 173 pruebas automáticas, y once de ellas existen únicamente para que las seis lecciones de este artículo no se pierdan en el próximo refactor. Esa es, para mí, la diferencia entre un análisis y un producto.
Si tienes un problema de asignación con restricciones reales —turnos, rutas, aulas, carga docente, disponibilidad de equipos— y estás decidiendo entre una heurística y un solver, mi recomendación es la misma que apliqué acá: construye la heurística primero, úsala como línea base, y deja que el solver demuestre con métricas que la supera. Si no puedes medir la mejora, no tienes una mejora: tienes una preferencia.
¿Estás enfrentando un problema parecido? Escríbeme y lo conversamos.
Deja una respuesta